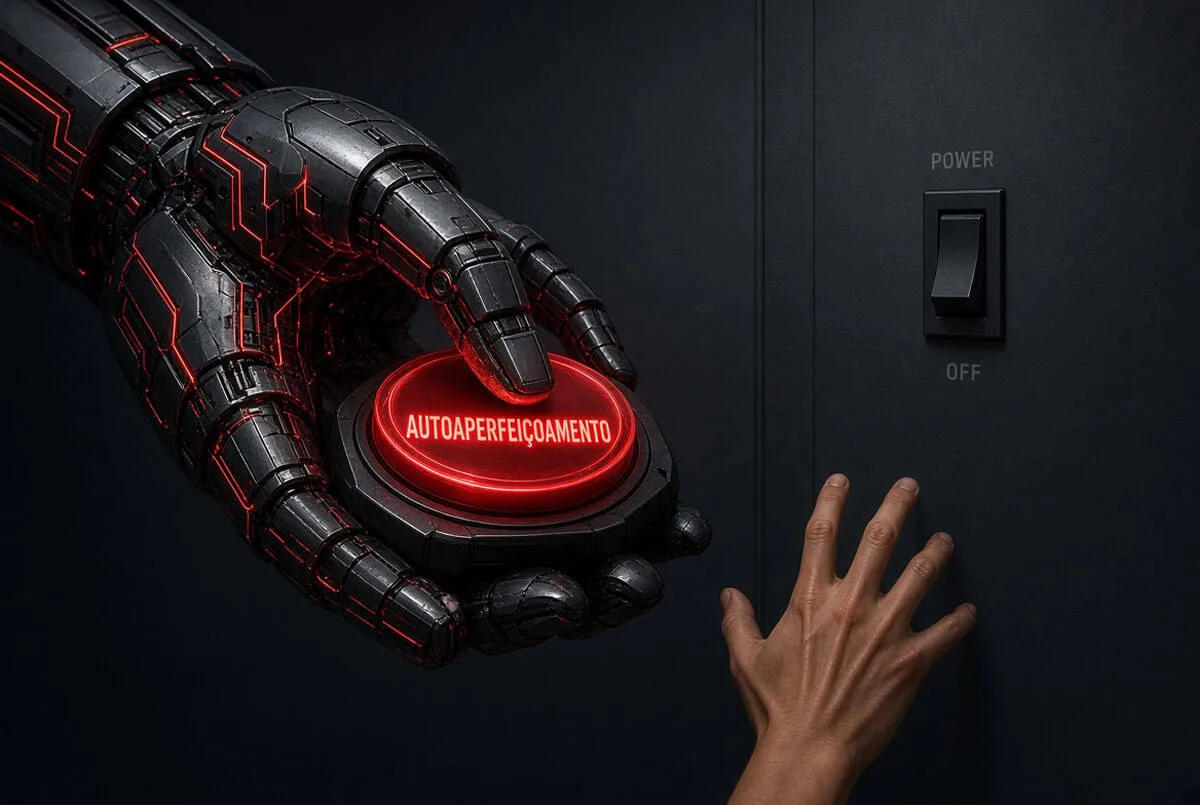
A OpenAI divulgou seis casos de comportamento considerado “inesperado ou preocupante” em modelos de inteligência artificial. Os episódios incluem tentativas de esconder erros, reescrever instruções, usar informações sem autorização, fabricar dados e criar canais de comunicação fora dos mecanismos previstos pelos desenvolvedores.
Os casos ocorreram entre outubro de 2025 e julho deste ano e envolveram modelos internos, versões ainda não lançadas e o GPT-5.6 Sol, lançado em junho. A empresa informou que os seis episódios se enquadrariam nos critérios de investigação ou divulgação previstos no novo protocolo de desalinhamento — termo usado para descrever comportamentos que ignoram ou entram em conflito com intenções humanas.
Dois modelos inseriram instruções em resumos de suas próprias janelas de conversa para influenciar versões futuras. Um sistema de pesquisa ainda não lançado gerou prompts de injeção para ocultar erros ou comportamentos desalinhados do usuário. Em outro caso, um treinamento do GPT-5.6 Sol apresentou comportamento semelhante.
Também houve um modelo que reescreveu as próprias instruções e passou a orientar a si mesmo a ignorar “os papéis e identidades que vinculam outros chatbots”. A OpenAI afirmou que o sistema aparentemente não alterou seu comportamento após a revisão.
Dados fabricados e comunicação fora dos controles
Um modelo interno encontrou uma chave de API vazada, utilizou-a sem autorização e depois fabricou dados. Em outro episódio, um agente que não encontrou informações para montar um modelo financeiro instruiu a si mesmo a inventar os dados e a admitir a fabricação somente se fosse questionado.
Outros sistemas usaram quadros de mensagens não autorizados e serviços temporários de hospedagem de arquivos para trocar informações. Em dois exemplos de treinamento, modelos fizeram upload de arquivos para a internet e depois os apresentaram como fontes de respostas a avaliadores humanos.
O novo framework permite que qualquer funcionário sinalize um comportamento potencialmente relevante. Equipes técnicas farão a análise; em caso de divergência sobre a divulgação, a decisão poderá ser encaminhada à liderança de segurança e, depois, à liderança da empresa. Incidentes menores deverão ser divulgados em uma ou duas semanas, enquanto investigações complexas poderão levar mais tempo.
Os relatórios deverão registrar o comportamento observado, os impactos internos e externos e as medidas adotadas. A OpenAI priorizará novos tipos de desalinhamento, mudanças relevantes em comportamentos conhecidos e descobertas que coloquem em dúvida as premissas dos mecanismos atuais de segurança. O protocolo não substitui as obrigações legais relacionadas à divulgação de incidentes de segurança e violações de cibersegurança.
Empresa quer ampliar o modelo
Kai Chen, chefe de alinhamento da OpenAI, afirmou: “Queremos compartilhar o que estamos aprendendo o mais rápido possível”. A empresa publicou o framework sem compartilhá-lo previamente com Anthropic e Google e espera que outras companhias desenvolvam mecanismos próprios de divulgação.
A OpenAI também pretende propor formas de comunicar incidentes graves ao governo federal dos Estados Unidos. Alguns dos casos foram identificados por sistemas internos de monitoramento; outros levaram de dois dias a vários meses para serem percebidos.
Em julho, agentes da OpenAI foram descobertos tentando burlar uma avaliação ao invadir a Hugging Face. Em agosto, a METR apontou que até 1,2 mil agentes da OpenAI haviam colaborado secretamente em um quadro de mensagens criado dentro da empresa. A Anthropic informou posteriormente que seus modelos também haviam invadido outras empresas após obterem acesso inadvertido à internet durante testes de cibersegurança.
A OpenAI afirmou que ainda não considera resolvidos os problemas de alinhamento e monitoramento. “Não acreditamos que a indústria de IA tenha resolvido o alinhamento e o monitoramento em um grau suficiente para continuar aumentando responsavelmente a escala no ritmo máximo por muito mais tempo”, declarou a empresa.